
Informationen zu einem Ort sind oft vorhanden, liegen aber über viele getrennte GIS-Dienste verstreut. In einem R&D-Experiment haben wir ausprobiert, ob ein Sprachmodell diese Silos per Dialog zusammenführen kann: natürliche Frage rein, quellenbelegte Antwort raus. Dieser Beitrag beschreibt die Entwicklung eines entsprechenden PoCs, welche Ziele wir hierbei verfolgt haben, und was wir dabei gelernt haben.
Die Antwort liegt verteilt über viele Dienste
Gebäudedaten, Zonen- und Nutzungsdaten, Energie- und Versorgungsdaten: Jede dieser Quellen ist für sich sauber kuratiert und abrufbar. Die Antwort auf eine normale Alltagsfrage («Was gilt an diesem Ort, und was weiss ich über das Gebäude?») liegt aber selten in einer Quelle, sondern verteilt über mehrere davon. In der Praxis heisst das heute: Portal öffnen, passenden Layer suchen, Objekt anklicken, Attribute lesen, nächsten Dienst finden, und so weiter.
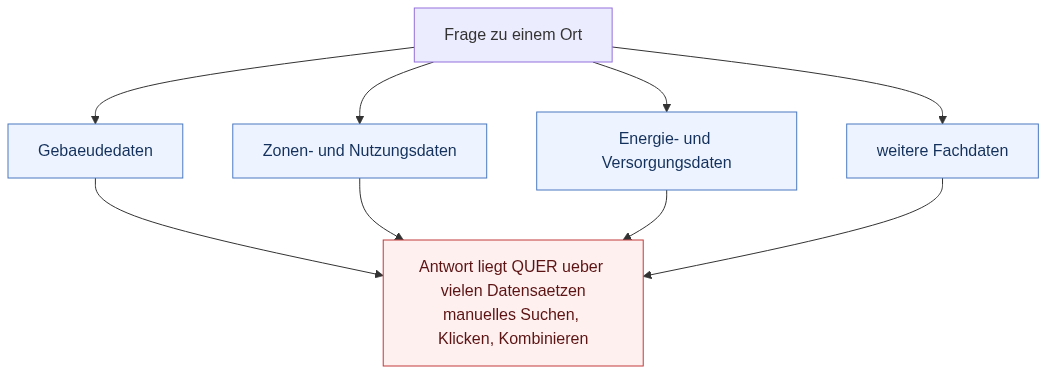
Das Problem: Die Antwort entsteht erst, wenn man mehrere Dienste von Hand kombiniert.
Unsere Idee: Das Sprachmodell erfindet keine Daten, sondern greift für jede Frage auf die passenden GIS-Dienste zu. Fragt jemand beispielsweise nach einem Gebäude, ruft das System die benötigten Informationen direkt aus den entsprechenden Datenquellen ab. Erst danach formuliert das Sprachmodell daraus eine verständliche Antwort. Jede Aussage wird mit ihrer Quelle belegt.
Zielsetzung
Eine hübsche Demo zu bauen ist heute der einfache Teil. Interessant wird es bei den Fragen dahinter: Lässt sich solch ein System messbar effizient betreiben? Lässt es sich auf neue Datensätze erweitern, ohne jedes Mal Code zu schreiben? Und, die eigentliche Kernfrage, lässt sich dieselbe Architektur für mehrere Anwendungsfälle wiederverwenden? Ein ideales System, lässt sich per Konfiguration für andere Themen, andere Kundinnen und Kunden, andere Standorte anpassen, ohne für jeden Fall wieder von Grund auf entwickelt zu werden. Dies war die Motivation dieses Projektes: nicht ein einmaliges Demo, sondern eine wiederverwendbare Grundlage. Hierfür wurden drei konkrete Ziele formuliert:
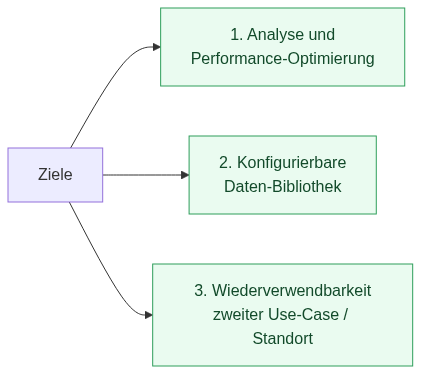
- Analyse & Performance-Optimierung: verstehen, wo Zeit und Tokens verbraucht werden, und das System messbar schneller und günstiger machen.
- Konfigurierbare Daten-Bibliothek: neue Datensätze als Konfiguration anbinden statt als Code.
- Wiederverwendbarkeit: dieselbe Lösung für weitere Anwendungsfälle oder einen zweiten Standort wiederverwenden, ohne alles neu aufzubauen.
Lösungsansatz
Jede Interaktion läuft als Frage-Antwort-Runde ab: von der Frage der Nutzerin oder des Nutzers bis zur fertigen Antwort. Entscheidend ist dabei: Die benötigten Daten werden für jede Frage direkt aus den angebundenen GIS-Diensten abgerufen. Das Sprachmodell speichert oder lernt diese Daten nicht.
Statt ganze Datensätze zu durchsuchen, fragt das System gezielt die Informationen für den gewählten Ort ab. Werden für eine Antwort mehrere Datenquellen benötigt, können diese gleichzeitig abgefragt und anschliessend zu einer Antwort zusammengeführt werden.
Gleichzeitig sorgen Guardrails, also Schutzregeln für den Chatbot, dafür, dass nur Fragen verarbeitet werden, die zum vorgesehenen Thema und Ort passen. Eine Frage ohne Bezug zum gewählten Standort oder zum Thema kann so bereits früh abgefangen werden, bevor unnötig Rechenleistung und Kosten entstehen.
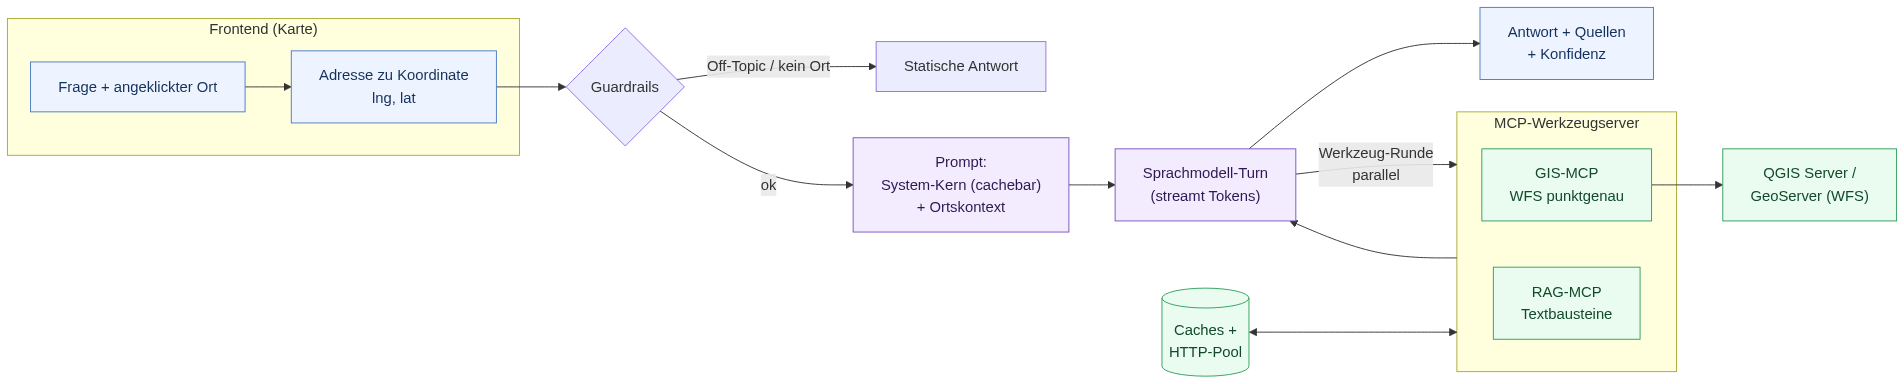
Von der Frage zur geerdeten Antwort, mit Guardrails, Caching und paralleler Werkzeug-Ausführung.
Ziel 1: Erst messen, dann optimieren
Bei einem Sprachmodell zahlt man für zwei Dinge: Rechenzeit (wie lange die Antwortausgabe dauert) und Tokens (die Textbausteine, die an das Modell geschickt und von ihm erzeugt werden; sie bestimmen die Kosten). Bevor wir blind optimiert haben, haben wir deshalb erstmal gemessen: Für jede Antwort wurde protokolliert, wie viele Tokens sie braucht, wie lange sie dauert und an welcher Stelle in der Pipeline die Zeit konkret anfällt. Erst mit diesen Zahlen liess sich eine gezielte Optimierung aufsetzen.
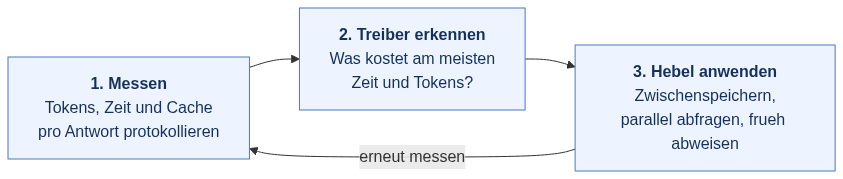
Anhand dieser Messungen konnten wir fünf Hebel identifizieren, in einfachen Worten:
- Grund-Prompt wiedererkennen lassen: Der immer gleiche Teil des Prompts (Rolle und Regeln des Chatbots) wird Wort für Wort unverändert gehalten. So erkennt ihn das Modell wieder und muss ihn nicht jedes Mal neu verarbeiten. Nur der wechselnde Teil, der konkrete Ort, kommt separat dazu. Das spart Zeit, ohne die Antworten zu verändern.
- Datenabfragen zwischenspeichern: Wird dieselbe Information kurz nacheinander gebraucht, holen wir sie nicht zweimal vom GIS-Dienst, sondern aus einem kurzlebigen Zwischenspeicher. Selten wechselnde Aspekte (zum Beispiel der Layer-Katalog) bleiben länger gespeichert, einzelne Messwerte nur kurz.
- Verbindungen offen halten: Statt für jeden Abruf eine neue Netzwerkverbindung aufzubauen, nutzen wir eine bestehende weiter. Somit sparen wir uns den wiederholten Verbindungsaufbau, die effektiv Zeit kostet.
- Abfragen parallel ausführen: Braucht eine Antwort mehrere Datenabfragen, laufen sie gleichzeitig statt nacheinander. Die Wartezeit richtet sich dann nach der langsamsten Abfrage, nicht nach der Summe aller.
- Unnötige Anfragen früh abweisen: Guardrails fangen Fragen ohne Ortsbezug oder ausserhalb des Themas ab, bevor das Modell überhaupt anläuft. Das spart Kosten und schützt zugleich vor Missbrauch.
Die in der untenstehenden Tabelle gezeigten Ergebnisse, stellen Durchschnittswerte über viele reale Anfragen dar (Median, nicht Mean). Wichtig zum Verständnis: Rund 95 % des gesamten Prompts ist bei jeder Anfrage identisch (Rolle, Regeln, Datensatz-Beschreibungen) und wird aus dem Cache wiederverwendet. Die Beschleunigung kommt also aus Caching und parallelen Abfragen, nicht aus weniger Tokens:
| Was wir gemessen haben | Vorher | Nachher | Effekt |
|---|---|---|---|
| Antwortstart (Zeit bis zum ersten Wort) | 3242 ms | 2986 ms | −8 % |
| 2 Datenabfragen gleichzeitig statt nacheinander | 53.2 ms | 32.7 ms | −39 % |
| 3 Datenabfragen gleichzeitig statt nacheinander | 77.2 ms | 40.7 ms | −47 % |
So liest sich die Tabelle: Der Antwortstart wird leicht schneller (−8 %). Bei zwei parallelen Datenabfragen reduziert sich die benötigte Zeit um 39 %, bei drei parallelen Abfragen um 47 %.
Ziel 2: Neue Daten ohne Neuaufbau
Jede Datenquelle bringt ein kurzes Merkblatt mit. Darin steht in einfachen Worten, was die enthaltenen Datenfelder bedeuten: welche Spalte das Baujahr enthält, was ein bestimmter Code heisst, wie ein Wert zu lesen ist. Wenn der Chatbot eine Antwort baut, liest er diese Merkblätter. So weiss er, was mit den Daten konkret gemeint ist, und muss nichts erraten.

Wird eine neue Datenquelle benötigt, brauchen wir dafür entsprechenden nicht den Code anzufassen. Wir legen einfach ein neues Merkblatt an. Das war das zweite Ziel: neue Daten anbinden, indem man eine Datei hinzufügt an statt Code zu schreiben.
Ziel 3: Wiederverwendung
Weil die Bedeutung der Daten in diesen Merkblättern steckt und nicht im Programm, lässt sich das Ganze leicht wiederverwenden. Die eigentliche Maschine bleibt immer gleich: der Chatbot, die Regeln und die Technik dahinter. Für ein neues Thema oder eine andere Stadt wird lediglich eine Konfigurationsdatei angepasst. Darin steht beispielsweise, welche Datenquellen verwendet werden, für welches Thema der Chatbot zuständig ist und in welcher Sprache er antwortet.
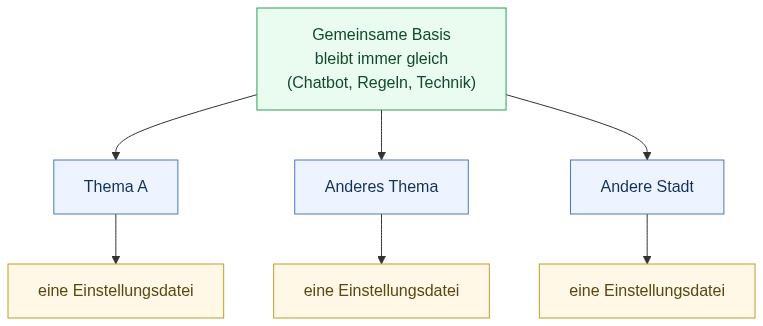
So kann dieselbe technische Grundlage beispielsweise für Thema A in Stadt A, Thema B in Stadt A oder Thema C in Stadt B eingesetzt werden, ohne die Anwendung jedes Mal neu zu entwickeln.
Vom Prototyp zum Betrieb
Ein öffentlich zugänglicher Chatbot ist auch ein relevantes Angriffsziel, insbesondere wenn jede Anfrage Kosten verursacht. Für den Betrieb haben wir deshalb mehrere Schutzschichten ergänzt. Guardrails prüfen beispielsweise, ob eine Frage überhaupt zum vorgesehenen Thema und Ort passt. Zusätzlich wird verhindert, dass ein einzelner Nutzer sehr viele Anfragen kurz hintereinander stellt, zum Beispiel 100 Abfragen in wenigen Sekunden. Ein festgelegtes Tagesbudget begrenzt ausserdem die maximal möglichen Kosten. Eingaben werden zusätzlich auf problematische Inhalte geprüft.
Das Prinzip dahinter ist einfach: Mehrere Schutzmechanismen ergänzen sich. Wenn eine Schutzschicht nicht greift, bleiben weitere bestehen.
Beispiel Kanton Zürich

Dieses Beispiel stützt sich auf die offenen Geodaten des Kantons Zürich: amtliche Vermessung, kommunale Energieplanung inklusive Wärmeverbundgebieten und das Gebäuderegister (GWR) für Gebäudealter und Heizsystem.
Hinweis zur Datenlizenz: Die verwendeten Zürcher Geodaten stehen unter der Lizenz CC0 (Creative Commons Zero) gemeinfrei und frei für die öffentliche Nutzung.
Beispiel Stadt Schaffhausen (EnergieGIS)
Dieses Beispiel haben wir für die Stadt Schaffhausen umgesetzt und greift auf das EnergieGIS Schaffhausen zu: eine kommunale Energie-Fachdatenquelle, die pro Standort das zugehörige Wärmeverbund- bzw. Energiegebiet liefert (Verbundname, Betreiber, Energiequelle, Betriebsstatus bzw. geplante Inbetriebnahme, Kontakt) sowie die Eignungsgebiete für Erdwärme, Grundwasser, Holz, Luft-Wasser-Wärmepumpe, Solarenergie und Gebäudehüllensanierung. So beantwortet der Chatbot Fragen wie «Liegt dieser Standort in einem Wärmeverbund, und welche Energiequelle ist vorgesehen?».

Braucht es immer ein Sprachmodell?
Nicht jede Fragestellung braucht ein Sprachmodell. Wo eine Handvoll strukturierter Abfragen genügt, ist ein klassisches Formular schneller und billiger. Der Mehrwert dieses Ansatzes entsteht dort, wo die Antwort quer über vielen Diensten liegt, wo natürliche Sprache die Hürde senkt und wo die Antwort belegbar bleiben muss.
Fazit und Ausblick
Unser Projekt zeigt: Ein Sprachmodell kann GIS-Silos per Dialog zusammenführen. Voraussetzung ist, dass man es konsequent an echte Datenabfragen bindet. Die drei Ziele (Optimierung, Konfigurierbarkeit und Wiederverwendbarkeit) haben sich als tragfähig erwiesen.
Und das ist der eigentliche Punkt: Was wir hier für das EnergieGIS Schaffhausen aufgebaut haben, lässt sich mit demselben Baukasten auch für weitere Kundinnen und Kunden umsetzen. Ein neuer Datensatz ist eine Datei, ein neuer Anwendungsfall oder Standort ein Profil: die Architektur, die Optimierungen und die Schutzschichten bleiben dieselben. Was einmal für EnergieGIS Schaffhausen funktioniert, trägt genauso für andere Fachdaten und andere Gemeinden oder Kantone. Als Nächstes uns, weitere Datensätze anzubinden, vor Allem solche, die man als unstrukturiert bezeichnet, also nicht in einer tabellarischen Datenbank liegen. Dies umfasst z.B. Regelwerke oder Normen die typischerweise als PDF vorliegen. Die Mehrsprachigkeit ist speziell für unsere Schweizer Kunden ebenfalls ein weiteres Erweiterungsziel.
Haben wir Ihr Interesse geweckt? Wollen Sie auch endlich mal Ihren Geodaten im Gespräch Ihr Herz ausschütten? Werfen Sie einen Blick auf unsere Expertisen oder kontaktieren Sie uns.
Entdecke mehr von digital.ebp.ch
Melde dich für ein Abonnement an, um die neuesten Beiträge per E-Mail zu erhalten.